2026年10月19日
Technology Watch

從實驗室到產業,追蹤新技術的路徑

← 回首頁

arXiv

fMRI 編碼模型同時為兩個腦區設計影像

AI 繪製的示意圖

NeuroVolve 將個人化腦部模型轉化為工具,能同時設計針對多個視覺腦區的影像。作者利用從 8 名受試者收集的 fMRI 資料訓練編碼模型,並用這些模型引導生成的圖片,讓它們朝向啟動或抑制指定腦區的方向發展。在視覺影像診所裡,如果新的掃描證實這些圖片確實如預測般改變真實的大腦活動,患者未來或許可以觀看為自己的大腦量身打造的場景。

如今,視覺神經科學實驗通常從一小批精心挑選的圖片開始。研究人員可能展示臉部,觀察某個腦區是否會對臉部作出反應;也可能展示房間,測試對場所敏感的腦區。這樣可以揭示某個腦區偏好什麼。但要找出能讓兩個腦區同時作出反應的組合,或讓一個腦區作出反應、另一個保持安靜的組合,就很困難。測試這些偏好如何因人而異,也需要昂貴的 fMRI 掃描,而大多數可能的圖片仍未經測試。

從圖片到腦部預測

fMRI 是一種測量與腦部活動相關、緩慢且間接變化的方法。它可以顯示哪些視覺特徵與大腦皮質不同部位的反應有關。編碼模型則從相反方向學習這種關係:它接收一張圖片,預測某個人的大腦可能產生的活動,細緻到稱為體素(voxel)的小單位。

這種預測很有用,但並不等同於測量真實的大腦。影像搜尋系統可能找出模型的弱點或盲點,並將它們誤認為真正的神經反應。而一張看起來合理的圖片,也不一定會在某個人的大腦中產生預期的活動。

可程式化的圖片搜尋

NeuroVolve 使用編碼模型作為搜尋指南。它從一張圖片開始,將圖片壓縮成一組視覺和語義特徵,然後逐步改變這些特徵。目標可以是提高某個腦區的預測活動、降低活動、同時啟動兩個腦區,或啟動一個腦區並抑制另一個。

接著,這些經過改變的特徵會交給擴散模型——這種影像生成器能將視覺特徵的描述轉換成合理的圖片。這讓 NeuroVolve 可以在結構化的特徵空間中搜尋,而不是直接改變每一個像素。最終結果可以在維持影像連貫性的同時,朝著與大腦相關的目標前進。

這套模型會為每名受試者個別建立。作者使用了 8 人觀看 10,000 張自然影像時所取得的全腦 7T fMRI 資料。對每個人而言,他們用 9,000 張圖片訓練預測器,並用 1,000 張所有人共同觀看的圖片進行檢查。接著,他們測試涉及臉部、身體、場所、文字、邊緣與對比度,以及色彩與曲率等相關腦區的目標。

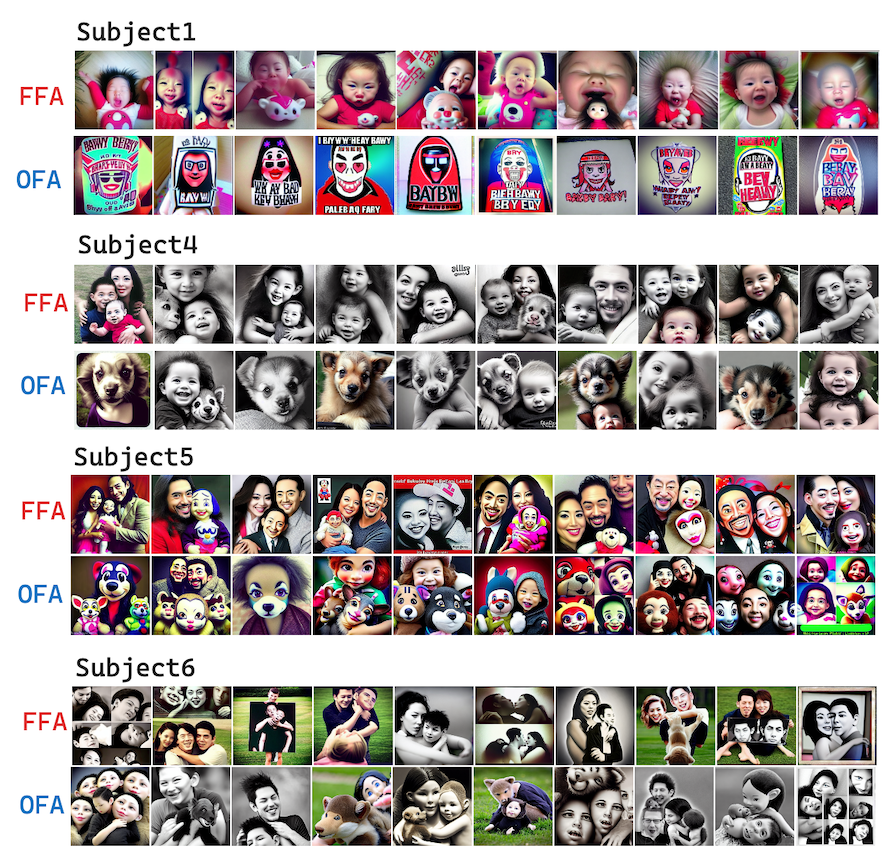
文中報告的結果,是這些編碼模型所作出的預測。在一項使用不同影像編碼器的評估中,生成的圖片比自然影像具有更高的預測啟動程度。不同人的輸出也各不相同。對一名受試者而言,針對臉部敏感區域的圖片傾向於呈現嬰兒臉孔;對另一名受試者而言,則傾向於呈現人群。這種差異正是重點之一:這套系統搜尋的是特定個人的模型所作出的預測,而不是假設每個人的大腦都以完全相同的方式使用視覺資訊。

圖 2:NeuroVolve 使用個人化的腦部活動預測器最佳化影像特徵,再利用所得路徑引導影像合成。

Refer to caption
Figure 3: Region-specific image evolution under neural objectives (S5). Starting from the same seed images (left column), we optimize toward a neural objective of maximizing voxel activity in six distinct visual ROIs: FFA (faces), EBA (bodies), PPA (places), mfswords (words), V1 (edges, contrast), and V4 (color, curvature). NeuroVolve successfully evolves each input into semantically distinct outputs, reflecting the known selectivity of each region. Notably, our method captures both high-level semantic preferences (e.g., faces for FFA) and low-level visual features (e.g., high spatial frequency for V1, rich colors and curvature for V4). Demonstrating fine-grained, region-specific tuning across the visual hierarchy.### 4.2 Modulating activity in a single region 出處: NeuroVolve: Evolving Visual Stimuli toward Programmable Neural Objectives(arXiv)
Refer to caption
Figure S1: Comparison between images generated by activating FFA versus OFA.Our method captures fine-grained differences across face-selective regions: optimization toward maximizing FFA responses produces more realistic human faces, whereas optimization toward maximizing OFA responses yields more abstract, stylized, or animal-like faces. 出處: NeuroVolve: Evolving Visual Stimuli toward Programmable Neural Objectives(arXiv)

如果圖片在真實大腦中有效

視覺影像診所未來有一天或許可以利用某人先前的掃描結果,建立一段量身打造的場景序列。臉孔可能變成人群肖像,房間可能變成風景;研究人員則測試特定的預測模式,而不是輪流播放一套通用圖片目錄。對科學家而言,這將以針對腦區如何互動、以及不同人之間的視覺處理有何差異的精準測試,取代挑選刺激物時的大部分猜測。

但這個未來取決於一項 NeuroVolve 尚未通過的測試。人們必須在新的 fMRI 實驗中實際觀看生成的圖片,而測得的反應也必須符合預期的變化。編碼模型在訓練所用的圖片之外,也必須繼續保持準確。個人化的神經資料同樣需要防護措施。在那之前,NeuroVolve 只是讓多腦區的大腦目標在模型中變得可程式化——還不是在活體大腦中變得可程式化。

圖 7:NeuroVolve 生成旨在抑制一個腦區、啟動兩個腦區,或在抑制另一個腦區的同時啟動一個腦區的圖片。

來源

arXiv,「NeuroVolve:讓視覺刺激朝向可程式化神經目標演化」