arXiv
fMRI 编码模型同时为两个脑区设计图像

NeuroVolve 将针对个人的脑模型变成一种工具,用于同时为多个视觉脑区设计目标图像。作者利用从 8 名受试者收集的 fMRI 数据训练编码模型,并用这些模型引导生成的图片,使其趋向于激活或抑制选定的脑区。在视觉成像诊所,如果新的扫描结果证实这些图片能像预测的那样改变真实的脑活动,患者或许可以观看为其自身大脑量身定制的场景。
如今,视觉神经科学实验通常从一小组精心挑选的图片开始。研究人员可能会展示人脸,以观察某个脑区是否会对人脸产生反应;也可能展示房间,以测试对地点敏感的脑区。这可以揭示某个脑区偏好什么。但要寻找能让两个脑区同时作出反应,或让一个脑区作出反应而另一个保持安静的组合,就很困难了。测试这些偏好如何因人而异,也需要昂贵的 fMRI 扫描,而大多数可能的图像仍未经过测试。
从图片到大脑预测
fMRI 是一种测量与脑活动相关的缓慢、间接变化的方法。它可以显示哪些视觉特征与大脑皮层不同部位的反应相关。编码模型则从相反的方向学习这种关系:它输入一张图像,预测某个人的大脑可能产生的活动,精确到称为体素的小型单位。
这种预测很有用,但它并不等同于测量真实的大脑。图像搜索系统可能会找到模型的弱点或盲区,并将它们误认为是真实的神经反应。而一张看起来合理的图片,也不一定会在人的大脑中产生预期的活动。
可编程的图像搜索
NeuroVolve 把编码模型用作搜索指南。它从一张图像开始,将其压缩成一组视觉和语义特征,然后逐步改变这些特征。目标可以是提高某个脑区的预测活动、降低其活动、同时激活两个脑区,或在激活一个脑区的同时抑制另一个。
随后,这些经过改变的特征会被交给扩散模型——这类图像生成器能够将对视觉特征的描述转换成一张合理的图片。这样,NeuroVolve 就能在结构化的特征空间中搜索,而不是直接改变每一个像素。最终生成的图片可以保持连贯,同时朝着与大脑相关的目标移动。
该模型针对每名受试者单独构建。作者使用了 8 人观看 10,000 张自然图像时采集的全脑 7T fMRI 数据。对于每个人,他们用 9,000 张图像训练预测器,并用 1,000 张所有人都看过的图像进行检查。随后,他们测试了涉及与人脸、身体、地点、文字、边缘和对比度,以及颜色和曲率相关脑区的目标。
文中报告的结果是这些编码模型作出的预测。在使用不同图像编码器进行的一项评估中,生成图片的预测激活程度高于自然图像。不同人的输出也有所不同。对于一名受试者,针对面孔敏感区域的图片倾向于出现婴儿脸;对于另一名受试者,这些图片则倾向于出现人群。这种差异正是该方法的意义所在:系统搜索的是某个特定人的模型所作出的预测,而不是假定每个人的大脑都以完全相同的方式使用视觉信息。


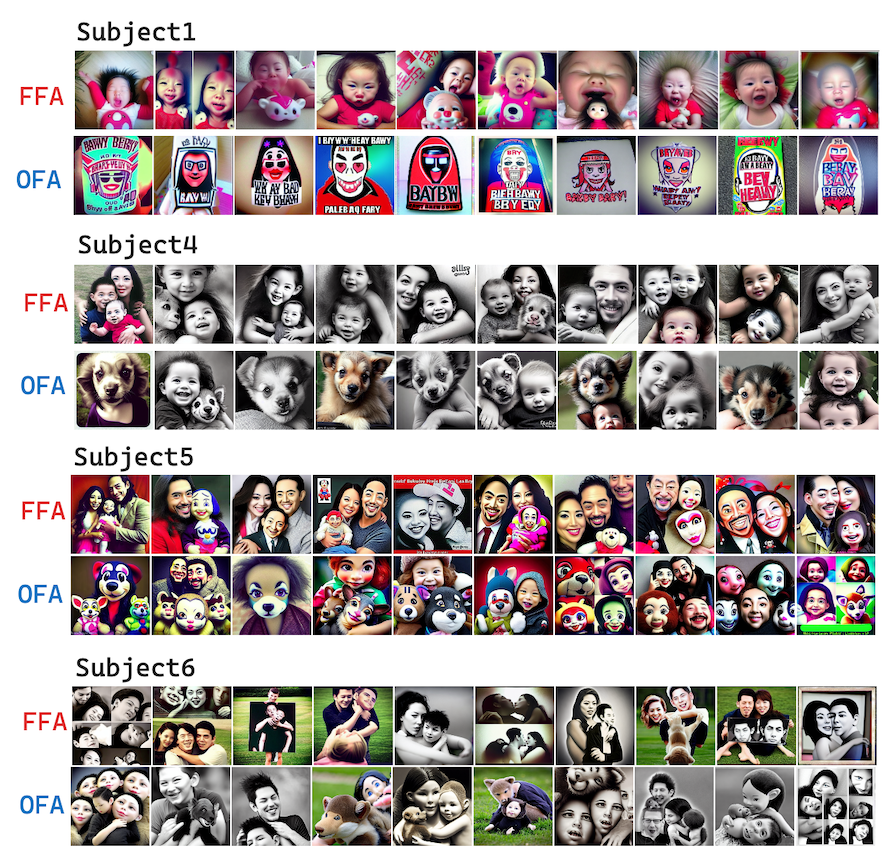
如果图片能在真实大脑中发挥作用
未来,视觉成像诊所或许可以利用一个人此前的扫描结果,生成一组为其量身定制的短场景序列。人脸可能变成一幅群像,房间可能变成一处风景,同时研究人员测试某种特定的预测模式,而不是轮流展示一套通用图片。对科学家来说,这将以针对性地测试脑区之间如何互动、以及不同人的视觉处理有何差异,取代选择刺激材料时的大部分猜测。
但这一未来取决于 NeuroVolve 尚未通过的一项测试。人们必须在新的 fMRI 实验中实际观看这些生成图片,而测得的反应必须符合预期的变化。编码模型在训练所用图像之外也必须保持准确。个性化神经数据同样需要安全保障。在此之前,NeuroVolve 只是让多脑区的大脑目标在模型中变得可编程——还没有让活人大脑变得可编程。
