arXiv
fMRIエンコーディングモデルが2つの脳領域向け画像を同時に設計する

NeuroVolveは、個人ごとの脳モデルを、複数の視覚領域を同時に狙った画像を設計するツールに変える。著者らは8人の被験者から集めたfMRIデータでエンコーディングモデルを訓練し、それを使って、選んだ領域の活動を高めたり抑えたりする画像を生成した。視覚イメージング診療所では、新たなスキャンによって画像が予測どおり実際の活動を変えることが確認されれば、患者は自分の脳に合わせた場面を見ることができるかもしれない。
現在、視覚神経科学の実験は通常、注意深く選んだ少数の画像から始まる。研究者は、脳領域が顔に反応するかを見るために顔を見せたり、場所に敏感な領域を調べるために部屋を見せたりする。これによって、ある領域が何を好むかは明らかにできる。しかし、2つの領域が一緒に反応する組み合わせや、一方が反応している間にもう一方が静かな組み合わせを探すのは難しい。こうした好みが人によってどう違うかを調べるにも高価なfMRIスキャンが必要であり、考えられる画像の大半は検証されないままだ。
画像から脳活動を予測する
fMRIは、脳活動に結びついたゆっくりした間接的な変化を測定する方法である。大脳皮質のさまざまな部分の反応と関連する視覚的特徴を示すことができる。エンコーディングモデルは、この関係を逆向きに学習する。画像を入力し、個人の脳が生じさせる可能性のある活動を、ボクセルと呼ばれる小さな単位に至るまで予測する。
この予測は役に立つが、実際の脳を測定することとは同じではない。画像検索システムは、モデルの弱点や見落としを見つけ、それを本物の神経反応と取り違える可能性がある。また、見た目に筋の通った画像が、ある人に意図した活動を生じさせる画像とは限らない。
画像のプログラム可能な探索
NeuroVolveはエンコーディングモデルを探索の案内役として使う。まず画像を視覚的・意味的特徴の集合に圧縮し、その特徴を段階的に変えていく。目的は、1つの領域で予測活動を高めること、活動を下げること、2つの領域を同時に活性化すること、あるいは一方を活性化しながらもう一方を抑えることである。
変化させた特徴は次に拡散モデルへ渡される。拡散モデルは、視覚的特徴の説明をもっともらしい画像に変えるタイプの画像生成モデルである。これによってNeuroVolveは、すべてのピクセルを直接変えるのではなく、構造化された特徴空間を探索できる。結果は一貫した画像のまま、脳に関する目標へ近づいていくことができる。
モデルは被験者ごとに作られる。著者らは、10,000枚の自然画像を見た8人から得た全脳7T fMRIデータを使った。それぞれの被験者について、9,000枚の画像で予測器を訓練し、共通する1,000枚の画像で検証した。その後、顔、身体、場所、単語、エッジとコントラスト、色と曲率に関連する領域を含む目標をテストした。
報告された結果は、これらのエンコーディングモデルによる予測である。別の画像エンコーダーを使った評価では、生成画像は自然画像より高い予測活性を示した。出力は人によっても異なった。ある被験者では、顔に敏感な領域を狙った画像は赤ちゃんの顔に近づく傾向があり、別の被験者では人々の集団に近づく傾向があった。この違いこそがこの手法の要点の一つである。すべての脳が視覚情報をまったく同じ方法で使うと仮定するのではなく、特定の人のモデルが予測するものを探索するからだ。


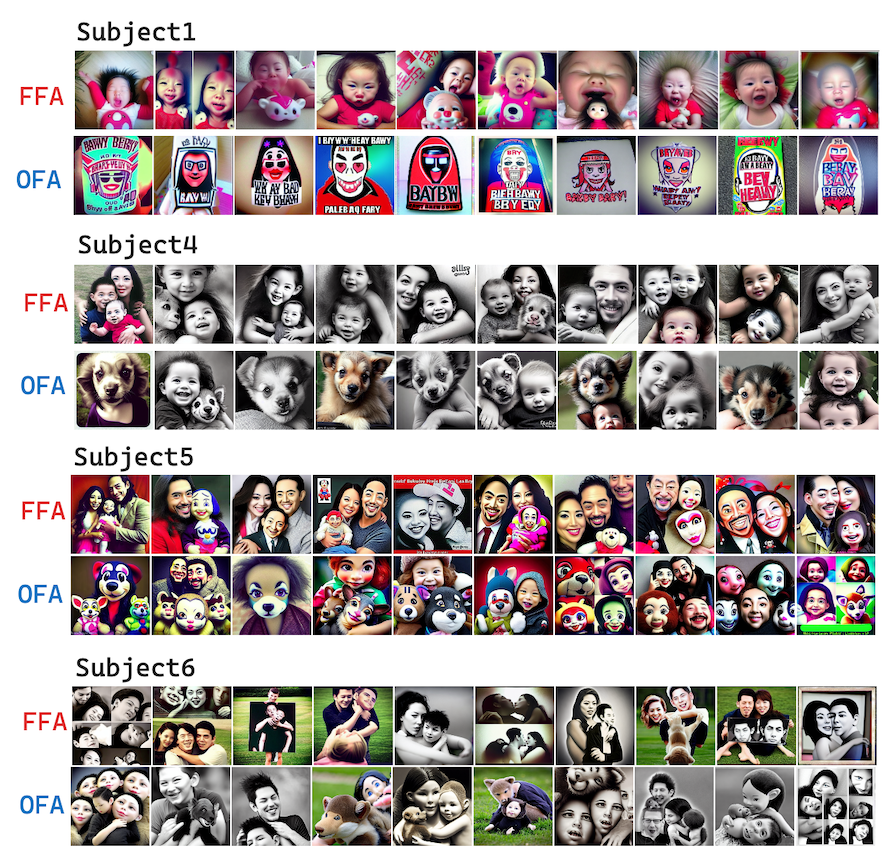
画像が実際の脳で機能するなら
視覚イメージング診療所では、いつか人の以前のスキャンを使って、その人に合わせた短い場面の連続を作れるようになるかもしれない。顔が集合写真に変わったり、部屋が風景に変わったりする一方で、研究者は一般的な画像カタログを順に見せるのではなく、予測された特定のパターンを検証する。科学者にとってこれは、刺激を選ぶ際の当てずっぽうの多くを、領域同士がどう相互作用するか、視覚処理が人によってどう異なるかを調べる的を絞ったテストに置き換えることになる。
しかし、その未来にはNeuroVolveがまだ合格していないテストが必要である。人々が実際に新しいfMRI実験で生成画像を見て、測定された反応が意図した変化と一致しなければならない。エンコーディングモデルは、訓練に使った画像以外でも正確であり続ける必要がある。個人の神経データにも保護策が必要になる。それまでは、NeuroVolveはモデルの中で複数領域の脳活動目標をプログラム可能にしたにすぎない。生きた脳でプログラム可能にしたわけではまだない。

出典
arXiv「NeuroVolve: Evolving Visual Stimuli toward Programmable Neural Objectives」